La inteligencia artificial (IA) está estableciendo nuevos estándares en el ámbito del almacenamiento. A medida que la demanda de procesamiento de datos crece, las unidades de procesamiento gráfico (GPU) no pueden permitirse estar inactivas mientras esperan operaciones de entrada/salida (E/S). Las aplicaciones de streaming, las integraciones y los artefactos intermedios no pueden verse obstaculizados por cuellos de botella en el manejo de objetos pequeños. Por otro lado, la inferencia de modelos de lenguaje de gran tamaño (LLM, por sus siglas en inglés) no se puede escalar si la caché de clave-valor (KV) permanece atrapada en la memoria de la GPU, en lugar de liberar los recursos necesarios para alimentarlas a máxima velocidad.
Desde el lanzamiento de ObjectScale 4.0 hace poco más de un año, la plataforma ha incorporado mejoras en el rendimiento, tanto para objetos pequeños como grandes. Estas mejoras incluyen tecnologías como RDMA, rutas de datos optimizadas para GPU y la descarga de cachés KV, todo ello en combinación con servidores Dell PowerEdge completamente flash que mantienen la arquitectura a exaescala, la eficiencia y la simplicidad necesarias para las empresas. Este enfoque en el rendimiento ha llevado a que ObjectScale fuera nombrado “Producto del Año 2025” por CRN en la categoría de almacenamiento de clase empresarial, un reconocimiento que subraya su impacto en los desafíos de datos empresariales actuales.
Una plataforma, ganancias en el rendimiento compuesto
En pruebas internas realizados en servidores Dell PowerEdge habilitados para ObjectScale, se ha demostrado un rendimiento de lectura por nodo de hasta 40 GB/s, hasta ocho veces más rápido que las plataformas de objetos totalmente flash de la generación anterior. Este aumento significativo proporciona un motor compacto de gran ancho de banda para conjuntos de entrenamiento, puntos de control y cargas de trabajo de tamaño mixto en los equipos de IA.
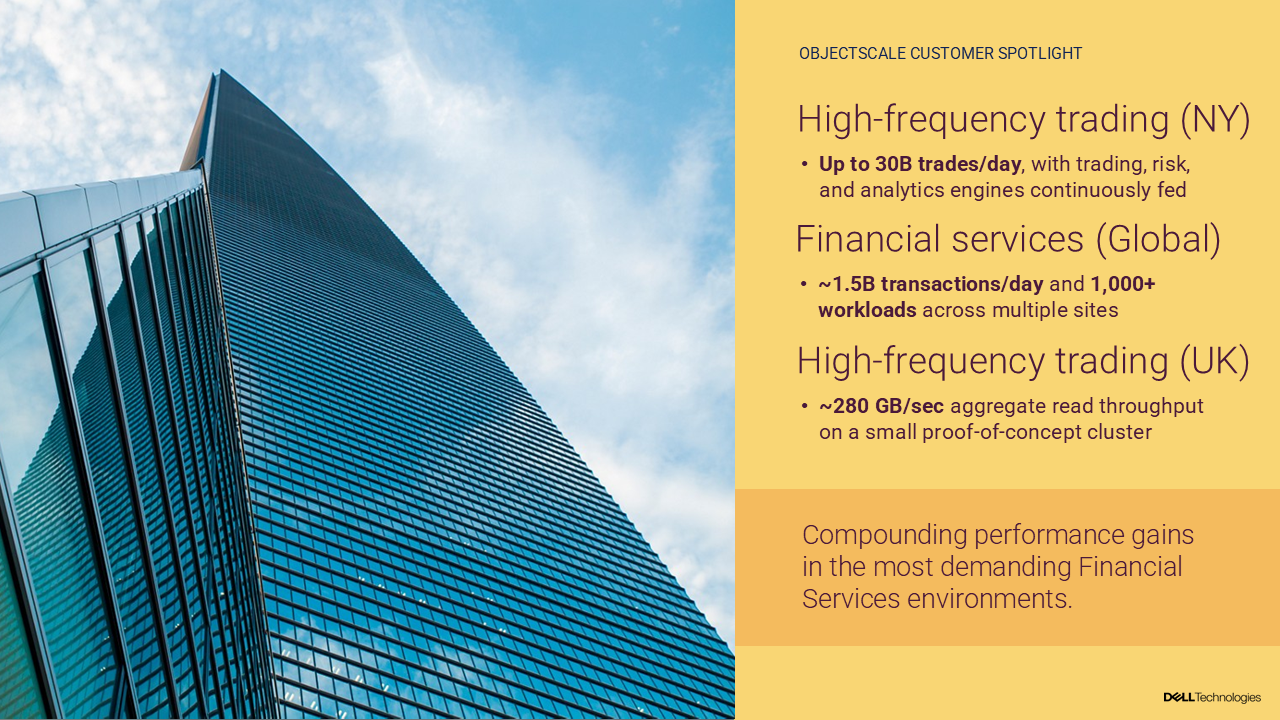
Los beneficios de ObjectScale van más allá del laboratorio. Actualmente, se está probando su eficacia en algunos de los entornos más exigentes, tales como:
-
Comercio de alta frecuencia a gran escala: Una importante empresa de comercio de alta frecuencia (HFT) en Nueva York procesa más de 30.000 millones de transacciones diarias, confiando en ObjectScale para abastecer continuamente los motores de comercio, riesgo y análisis con datos.
-
Servicios financieros globales: Una compañía financiera multinacional utiliza un entorno ObjectScale basado en unidades de disco duro (HDD) y con sitios múltiples para gestionar 1.500 millones de transacciones diarias, mientras atiende más de 1.000 cargas de trabajo de IA, análisis y copias de seguridad a través de un autoservicio automatizado.
-
Comercio de alta frecuencia en el Reino Unido: Una firma de comercio HFT radicada en el Reino Unido ha mantenido un rendimiento total de lectura de aproximadamente 280 GB/s en un pequeño clúster de prueba de concepto de ObjectScale.
Objetos pequeños, gran rendimiento: optimizaciones de almacenamiento por fragmentos y de clave-valor
Los pipelines de IA modernos están dominados por objetos pequeños, incluidos registros, métricas, funciones, segmentos de tabla, fragmentos de vectores y artefactos de entrenamiento intermedios. Si el nivel de objetos no gestiona pequeños objetos de manera eficiente, todo el proceso se ralentiza. ObjectScale permite a los clientes establecer pipelines de IA que manejan tanto objetos pequeños como grandes de forma eficaz.
Para lograr esto, emplea un motor de almacenamiento por fragmentos que empaqueta muchos objetos pequeños en bloques de 128 MB antes de aplicar códigos de corrección de errores y distribuir los datos entre los nodos. En el caso de archivos típicos de 10 kB, un solo fragmento puede albergar más de 10.000 objetos, lo que reduce la sobrecarga de metadatos y el trabajo de reconstrucción.
¿Qué significa esto para los clientes?
-
Mayor rendimiento de objetos pequeños y menor latencia: especialmente en clústeres ObjectScale XF960 totalmente flash y basados en HDD X560, optimizados para lecturas de objetos pequeños.
-
Reconstrucciones más rápidas y rendimiento más predecible: los códigos de corrección de errores de borrado basados en fragmentos reducen el número de fragmentos que deben recrearse tras fallos en discos o nodos, lo que permite a las grandes unidades NVMe ser reconstruidas en horas, en lugar de semanas.
-
Menos desperdicio de CPU en el análisis en segundo plano: ObjectScale calcula las sumas de verificación de los objetos en línea y las verifica en el nivel de banda, liberando, así, ciclos de CPU para lecturas y escrituras activas.
Con ObjectScale 4.2, se introduce un almacén de clave-valor rediseñado que ofrece una eficiencia de memoria cuatro veces mayor y una reducción del uso de disco entre 30 % y 60 % para metadatos. Las búsquedas continúan siendo rápidas y predecibles, incluso a medida que los clústeres y el número de objetos crecen.
Alimentación de GPU y LLM: S3 a través de RDMA y caché KV
A medida que los equipos de IA amplían tanto el entrenamiento como la inferencia, el principal cuello de botella no radica en el poder de computación bruto, sino en el movimiento de datos y la memoria de contexto. Las versiones de cuarta generación de ObjectScale abordan esta cuestión desde ambas perspectivas.
S3 a través de RDMA: Acceso a objetos de alto ancho de banda y baja latencia
Introducido en ObjectScale 4.2 y mejorado en 4.3, el acceso a S3 a través de RDMA sustituye el tradicional TCP por RDMA, lo que ofrece enormes beneficios en pruebas internas:
-
Rendimiento hasta un 230 % mayor.
-
Una latencia aproximadamente un 80 % menor.
-
Y hasta un 98 % menos de uso de la CPU.
Con la versión 4.3, S3 a través de RDMA está disponible a través de toda la cartera totalmente flash de ObjectScale (R7725xd, XF960 y EXF900), permitiendo un acceso a datos de objetos con una latencia ultrabaja y un rendimiento elevado.
Integrando el SDK S3 a través de RDMA de Dell con soporte para GPU y una pila de red RoCEv2, ObjectScale elude cuellos de botella típicos de TCP y CPU, creando una vía casi directa entre las GPU y las SSD NVMe en el almacenamiento de objetos para pipelines de IA exigentes.
Caché KV: Convertir ObjectScale en un acelerador de inferencia
A medida que los LLM se vuelven más comunes en producción, la caché de clave-valor (KV) se vuelve esencial. En lugar de recalcular estados de atención para cada token, las infraestructuras de inferencia reutilizan la caché KV, que, rápidamente, puede desbordar la memoria de la GPU. Descargar esta caché a ObjectScale permite experiencias de IA más rápidas y receptivas.
La solución escalable de descarga KV de Dell, utilizando tecnología ObjectScale y PowerScale, transfiere esta caché de la memoria GPU a un almacenamiento compartido de alto rendimiento mediante vLLM, LMCache, la biblioteca NIXL de NVIDIA y la integración S3 acelerada por RDMA de Dell.
Los benchmarks muestran:
-
Tiempo hasta el primer token (TTFT) hasta 19 veces más rápido en comparación con una configuración estándar de vLLM que recalcula la caché KV en la GPU.
-
Rendimiento de tokens hasta 5,3 veces mayor y rendimiento multiturno casi tres veces superior en las pruebas de Dell InfoHub, incluso con cachés KV de varios gigabytes almacenadas en ObjectScale y PowerScale.
-
TTFT de caché KV de aproximadamente 0,86 segundos en ObjectScale, superando a la competencia en pruebas publicadas.
Tablas S3: Análisis optimizados para IA sin la carga de ETL
En ObjectScale 4.3 (vista previa técnica), las tablas S3 integran análisis nativos basados en Apache Iceberg directamente en los depósitos de ObjectScale. Estas tablas pueden ser consultadas por motores como Spark, Flink, Trino y Starburst sin necesidad de copiar datos en bases de datos o almacenes independientes, lo que reduce las sobrecargas de ETL y las dependencias externas.
Las pruebas internas han mostrado:
-
Recopilación hasta el doble de rápida.
-
Consultas hasta 4,5 veces más rápidas.
Al comparar estos resultados con patrones tradicionales centrados en almacenes, la recuperación de almacenamiento se automatiza y el IAM unificado ayuda a mantener un alto rendimiento y a simplificar las operaciones a lo largo del tiempo. ObjectScale se transforma de una simple zona de inicio a una superficie de análisis activa y de alto rendimiento para los equipos de IA y BI.
Rendimiento sin renunciar a la capacidad de ampliación, la eficiencia o la sencillez
El rendimiento es útil solo si se combina con la capacidad de ampliación, la eficiencia y la sencillez. Las versiones de cuarta generación de ObjectScale también han mejorado en estos aspectos:
-
Un almacén de clave-valor modernizado puede soportar un crecimiento global de VDC de hasta un 122 % en comparación con versiones anteriores, utilizando significativamente menos memoria y espacio en disco para metadatos.
-
La compresión en el nivel de depósito y varios algoritmos (